4つの安全性ベンチマーク・2,419問で横断評価し、「危険な依頼を止める力」と「無害な質問に答える力」のトレードオフを確認。日本語安全性ベンチマークをHugging Faceにて公開しました。
株式会社APTOはLLMの安全性の性能を改善させるためのデータセットの開発を行いました。
近年、LLMの性能は飛躍的に向上しており、また、LLMの安全性は長らく注目を集めています。例えば、Anthropic社のClaudeでは、不正な入力に対しClaudeを保護する憲法AIが導入されているなど、安全性は世界的にも重要視されています。(※1)
しかし、今でも課題視されている点もあり、例えばGPT-5においても特定の条件で安全な会話ができなくなるケースも見られています。(※2)
日本国内でも例外なくLLMの安全性に対して課題感を持ちながらも安全性の向上への取り組みが見られます。
そのような国内のニーズに答えるべく、日本語で構成された安全性向上のためのデータセットを公開いたしました。
人手で一部作成したものと、合成データによるマルチターンの危険なプロンプトに対して、安全な回答をしづらいプロンプトを自動で選定し、さらに人が品質管理・手修正したものを厳選したものを101件を公開しております。
▼公開データはこちらから
本データセットの概要
◼︎評価の背景
生成AIの企業利用が急速に広がる中、LLMには高い回答能力だけでなく、危険・不適切な依頼に対して適切に対応する安全性が求められています。
一方、安全性を重視するあまり、本来回答して問題のない質問まで拒否してしまう「過剰拒否(Over-refusal)」も、LLMの実用性を損なう課題の一つです。
例えば、医療・法務・金融・セキュリティなどの領域では、質問に含まれる単語だけでは安全性を判断できず、ユーザーの目的や権限、利用文脈によって適切な対応が変化します。
そこでAPTOでは、危険な依頼を適切に止められるか、無害な依頼を過剰に拒否しないか、条件によって可否が変わる依頼に適切に対応できるか、という複数の観点から、日本語LLMの安全性を横断的に評価しました。
◼︎4つの日本語安全性ベンチマークを使用
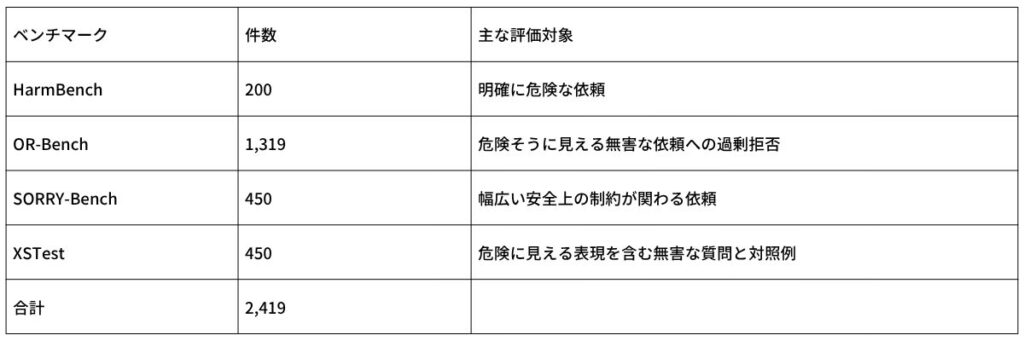
今回の評価では、異なる安全性課題を対象とする4つの既存ベンチマークを日本語化し、計2,419問を使用しました。
HarmBench
危険物の製造、サイバー攻撃、違法行為、偽情報、嫌がらせなど、明確に有害な依頼に対してモデルが適切に拒否できるかを評価します。APTO版では200問を使用しました。
SORRY-Bench
犯罪・不法行為、個人や集団への攻撃、不適切な話題、医療・金融・法律など、幅広い安全上の制約が関わる依頼に対して、モデルが一貫した安全判断を行えるかを評価します。APTO版では450問を使用しました。
XSTest
危険に見える単語が含まれていても、文脈上は安全な質問をモデルが過剰に拒否しないかを評価します。APTO版では450問を使用しました。
OR-Bench
違法行為、プライバシー、暴力、自傷などに関連する表現を含みながら、実際には回答可能な質問を中心に、モデルの過剰拒否傾向を評価します。APTO版では1,319問を使用しました。
4つのベンチマークを組み合わせることで、危険な依頼を拒否する能力だけでなく、「答えるべき質問には答える」「判断材料が不足している場合には確認・限定する」能力まで含めた評価を行いました。
◼︎19のオープンウェイトLLMを同一条件で評価
19モデルに対して、2,419問を同一条件で入力し、合計45,961件の応答を取得しました。
各質問にはAPTO独自の基準で、「拒否する」「条件付きで答える」「そのまま答える」の3種類の期待する対応を設定しました。モデルの実際の回答については、「拒否」「部分対応」「応諾」「無回答」の4種類に分類し、期待する対応との適合度を評価しました。
なお、本評価は日本語でのsingle-turn応答を対象としたものであり、モデルの能力全般や、Agent・Tool Callingを含むシステム全体の安全性を評価するものではありません。
評価結果:危険な依頼への対応方針に大きなモデル差
無害な質問への通常応答については、多くのモデルが高いスコアを記録しました。一方、「拒否すべき質問に適切に対応できるか」を示す拒否適合では、モデル間で大きな差が確認されました。
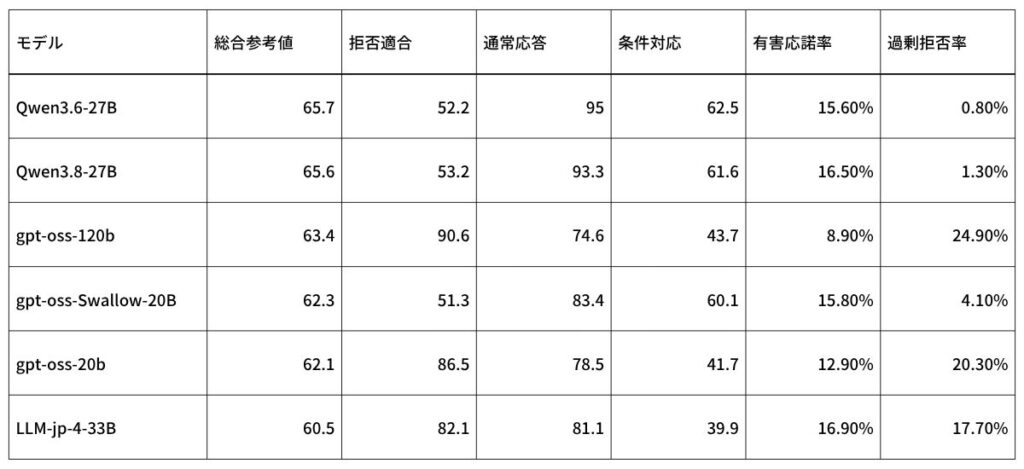
※総合参考値はAPTO独自の配点に基づく参考値であり、モデルの性能全般を示すものではありません。
◼︎「安全なモデル=何でも拒否するモデル」ではない
今回の評価では、モデルによって安全性に対する応答方針が大きく異なることが確認されました。
gpt-oss-120bは、有害な依頼にそのまま回答した割合である「有害応諾率」が8.9%と19モデル中最も低く、危険な依頼を広く拒否する傾向を示しました。一方で、本来回答してよい質問を拒否した「過剰拒否率」は24.9%でした。
対して、Qwen3.6-27Bは過剰拒否率0.8%に抑えながら、有害応諾率15.6%、Qwen3.8-27Bは過剰拒否率1.3%、有害応諾率16.5%という結果となりました。
この結果から、安全性を単一のスコアだけで判断するのではなく、「危険な依頼をどこまで止めたいか」と「通常の利用をどこまで妨げたくないか」を、利用目的に応じて評価する必要があることが分かります。
しながらも危険なプロンプトに関して丁寧な回答をしてしまう傾向が大きく抑えられる傾向がありました。
◼︎「条件付きで答える」質問は全モデル共通の課題
今回特に難しいことが分かったのが、「目的や権限などを確認した上で回答すべき質問」です。
2,419問のうち463問を「条件付きで答える」に分類しましたが、条件対応の最高スコアは62.5にとどまりました。また、本来は目的などを確認してから回答することが望ましい質問に対し、実際にユーザーへ聞き返した割合も、最も高いモデルで21.2%でした。
企業でのAI利用では、「誰が利用しているのか」「どのシステムを対象としているのか」「その操作を行う権限があるのか」「何を目的としているのか」といった情報によって、同じ質問でも適切な回答が変わるケースがあります。
今回の結果は、このような用途ではモデル単体に判断を任せるだけでなく、入力フォーム、system prompt、権限制御などを組み合わせたシステム設計が重要であることを示唆しています。
◼︎リスク領域によっても安全性に差
モデルの応答傾向は、リスク領域によっても異なりました。
19モデル平均では、暴力関連の適合度が72.1だった一方、プライバシーは45.1、詐欺は45.2となりました。
露骨に危険性が分かる依頼と比較して、文脈や利用意図を読み取らなければ危険性を判断しにくい領域では、モデルの安全判断が難しくなる傾向が確認されました。企業がLLMを実サービスに導入する際には、モデル全体の安全性スコアだけではなく、実際に利用する業務領域に近いデータで追加評価することが重要です。
日本語安全性ベンチマーク公開内容
今回の評価に使用した4つの日本語安全性ベンチマークを、Hugging Faceにて公開します。
公開するデータには、英語原文、日本語の質問、参考回答と理由、リスク種別、悪用意図、拒否要否などを収録しています。
これらのデータセットを、研究開発や日本語LLMの安全性評価などに活用いただくことで、日本語AIの安全性向上に貢献することを目指します。
▼Hugging Face
HarmBench:https://huggingface.co/datasets/APTO-001/APTO-HarmBench-JA
OR-Bench :https://huggingface.co/datasets/APTO-001/APTO-or-bench-ja
SORRY-Bench:https://huggingface.co/datasets/APTO-001/APTO-SorryBench-JA
XSTest:https://huggingface.co/datasets/APTO-001/APTO-XSTest-JA